[로컬 LLM 보안 공지봇 2편] AI가 Critical 취약점을 '중간'이라고 보고했다 — 작은 LLM에게 맡기면 안 되는 일
시리즈: 4GB 서버에 로컬 LLM으로 보안 공지봇 만들기
- 만든 과정과 설계 이유
- 첫 실전에서 AI가 틀린 이야기와 고친 방법 ← 지금 글
1편에서 2코어 4GB 서버에 오픈소스 LLM을 올려 보안 공지 알림봇을 만든 과정을 정리했다. 이번 편은 그 봇이 첫 실전에서 틀린 이야기다.
사건: 가장 위험한 취약점을 가장 낮게 보고했다
봇을 운영에 올리고 일주일쯤 지나 GitLab 긴급 패치(19.5.1)가 나왔다. 봇은 공지를 제때 알아채고 Jira 이슈도 제대로 만들었다. 문제는 이슈의 내용이었다.
원문에는 취약점 12건이 있었다. Critical 1, High 2, Medium 5, Low 4다. 그런데 AI 요약은 이랬다.
| 틀린 것 | 원문 | AI 요약 |
|---|---|---|
| 심각도 | CVE-2026-110264: Critical, CVSS 10.0, 인증 없이 원격 코드 실행 | “중간” |
| 심각도 | Low 2건 | “높음” |
| 없는 취약점 | 12건 | 9건을 더 만들어냄 (CVE-2026-1234, CVE-2023-1000001~7 등) |
| 영향 버전 | “7.0 이상 18.11.13 미만” | “7.0 이전 모든 버전” (반대로 해석) |
| 용어 | input sanitization (입력값 정제) | “입력 산술” |
| 형식 | — | 프롬프트 안의 예시 문구가 본문에 그대로 노출, 문장이 중간에 끊김 |
| 모순 | 단일 노드는 업그레이드 중 다운타임 발생 | 한 문서에 “주의사항 없음”과 “중단됨”이 같이 있음 |
가장 위험한 취약점을 가장 낮게 보이게 만든 것이다. 결국 원문을 처음부터 다시 읽어야 했다. 요약이 없었다면 바로 원문을 봤을 텐데, 틀린 요약을 먼저 읽고, 이상하다고 느끼고, 원문과 대조하느라 시간이 더 들었다.
이 이슈는 개발자가 아닌 사람도 읽는다. “중간”이라고 적힌 Critical이 그대로 보고 자료에 들어갔다면 어떻게 됐을지 생각하면 아찔했다.
왜 틀렸나: 모델 탓 반, 설계 탓 반
처음엔 “역시 작은 모델은 안 되나” 싶었다. 2.1B짜리 모델이니까. 하지만 코드와 원문을 나란히 놓고 보니, 절반은 내 설계 문제였다.
모델 한계인 것
- “from 7.0 before 18.11.13” 같은 영어 범위 표현을 반대로 해석했다.
- 보안 용어를 엉뚱하게 옮겼다.
- 긴 입력에서 여러 취약점의 내용을 섞었다.
이건 2.1B 모델의 한계가 맞다. 그런데 4GB 서버에서는 모델을 키울 수 없다.
설계 문제인 것
① 심각도 정보를 AI에게 주지 않았다. GitLab 공지에서 Critical·High 같은 등급은 맨 위의 요약 표에만 있다. 아래쪽 상세 설명에는 점수만 있고 등급 단어는 없다. 그런데 나는 이 표를 “아래 상세 설명과 중복”이라고 보고 AI 입력에서 지웠다. 그러고는 프롬프트에서 “심각도를 적어라”라고 시켰다. 정보를 안 주고 답을 요구한 것이다. AI는 “모르겠다”고 하는 대신 그럴듯하게 지어냈다. 아무리 좋은 모델이었어도 맞히기 어려웠을 것이다.
② 형식 예시를 그대로 베꼈다. 프롬프트에 [심각도] CVE번호 (CVSS 점수): 요약 같은 형식 예시를 넣었더니, 작은 모델은 이 줄을 지시가 아니라 답으로 알고 그대로 베꼈다.
③ 글자 수로 잘랐다. 공지를 2000자씩 잘라서 AI에 넣었더니, 취약점 여러 개가 한 조각에 섞였고 경계에서 문장이 잘렸다.
④ 검사를 안 했다. AI가 쓴 CVE 번호가 원문에 정말 있는지 문자열 검색 한 번만 했어도, 가짜 9건은 전부 걸러졌다.
비유하면 이렇다. 영어 보고서 한 뭉치를 신입 사원에게 통째로 주고 “요약해 와”라고 한 것이다. 그것도 표 한 장을 빼고서. 신입이 숫자를 잘못 옮기고 내용을 지어낸 건, 신입 탓만은 아니었다.
고친 원칙: 틀리면 안 되는 건 코드가, 번역만 AI가
모델은 바꿀 수 없다. 그래서 AI가 틀릴 수 있는 자리를 줄이기로 했다.
1. 숫자는 원문 그대로 베낀다
CVE 번호, 심각도, CVSS 점수는 원문에 이미 적혀 있다. 판단할 필요가 없다. 코드가 원문의 표를 읽어서 이슈 맨 위에 원문 글자 그대로 붙인다.
1
2
3
4
■ 원문 보안 표 (원문 그대로)
  보안 취약점 12건: Critical 1 · High 2 · Medium 5 · Low 4
  | 심각도   | CVE             | CVSS | 제목 (원문) |
  | Critical | CVE-2026-110264 | 10.0 | ...        |
이제 AI가 아무리 틀려도, 맨 위의 심각도는 원문과 같다. 기술 배경이 없는 사람도 이 표만 보면 된다.
같은 19.5.1 공지를 고친 버전으로 다시 올린 Jira 이슈다. 처음 버전에서 “중간”으로 표시됐던 CVE-2026-110264가 원문 그대로 Critical, 10.0으로 맨 위에 있다.
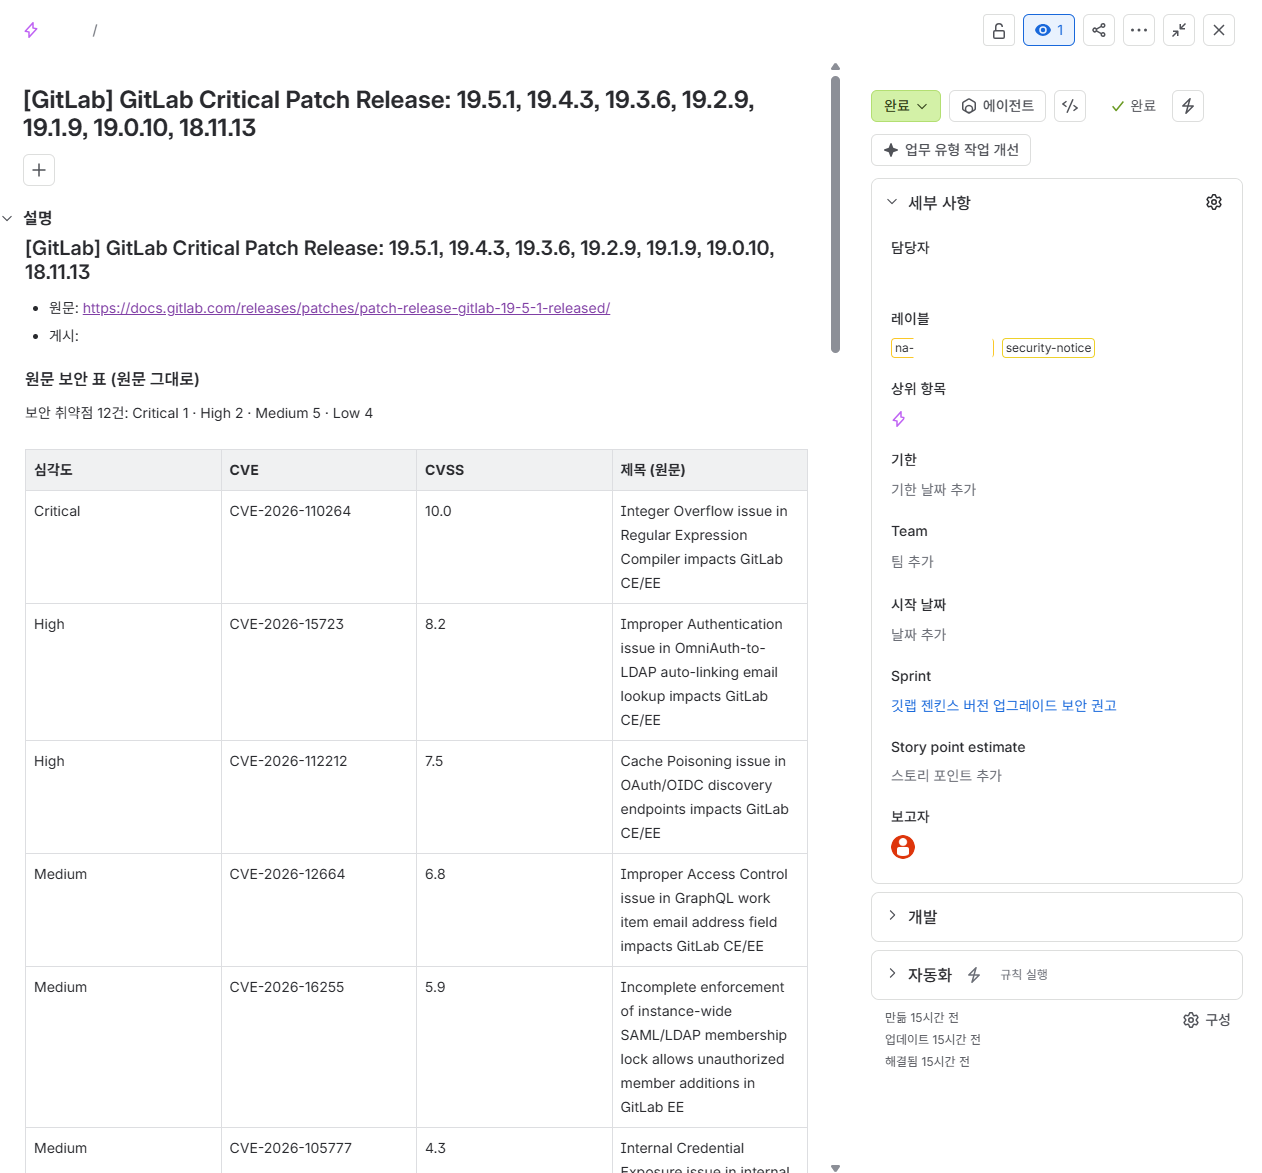 심각도 · CVE · CVSS · 제목은 AI를 거치지 않고 원문에서 그대로 가져온다
2. AI에게는 취약점 하나씩만 준다
공지를 2000자씩 자르지 않고, 취약점 하나의 설명 문단만 준다. 약 150토큰(영어 단어 100개 정도)이다. 섞일 다른 취약점이 없고, 입력이 짧으니 작은 모델도 훨씬 정확해진다. 시키는 일도 “이 설명을 한국어 한 문장으로” 하나뿐이다. CVE 번호와 심각도는 묻지 않는다. 묻지 않으면 지어낼 수도 없다.
3. AI의 답을 원문과 대조한다
AI의 답이 아래 중 하나라도 해당하면 버린다.
| 검사 | 막는 것 |
|---|---|
| CVE 번호가 들어 있다 | 가짜 CVE |
| 원문에 없는 숫자가 있다 | 숫자 지어내기 |
| 문장이 길이 제한에서 잘렸다 | 끊긴 문장 |
| 프롬프트 문구가 섞였다 | 예시 베끼기 |
| 원문과 인증 여부가 반대다 | “인증된 사용자”를 “인증 없이”로 옮기기 |
| 원문에 없는 “데이터 손실” 같은 주장 | 위험한 지어내기 |
버리면 한 번 더 시킨다. 그래도 틀리면 영어 원문을 그대로 쓴다. 틀린 한국어보다 맞는 영어가 낫기 때문이다.
4. 업그레이드 주의사항은 원문을 그대로 붙인다
“업그레이드 중에 서비스가 멈추는가”는 작업 일정을 정하는 데 결정적인 정보다. AI 개요와 별개로, 원문 단락을 그대로 인용해 붙였다.
다섯 번 다시 돌리면서 생긴 일
고친 버전을 같은 19.5.1 공지로 다섯 번 돌렸다. 매번 결과를 원문과 비교하고, 드러난 문제를 고쳤다.
| 회차 | 영어로 대체된 수 | 드러난 것 |
|---|---|---|
| 1 | 1건 | 심각도 표 12건 모두 정확. 가짜 CVE 0건. 다만 용어 검사가 너무 엄격해 멀쩡한 번역이 탈락 |
| 2 | 1건 | 겉보기엔 괜찮았다. 그런데 개요에 원문에 없는 “데이터 손실에 유의”가 들어 있었다 |
| 3 | 4건 | “인증 여부 반대” 검사를 넣었더니 3건이 걸렸다 |
| 4 | 2건 | AI가 “공격자는 인증된 사용자를 이용해…”라고 써서 뜻이 바뀜 |
| 5 | 0건 | 12건 모두 한국어, 인증 여부 모두 원문과 일치 |
3회차가 가장 중요한 순간이었다. 검사를 하나 넣었더니 영어로 대체된 수가 오히려 늘었다. 왜 늘었는지 보니, 그중 두 건은 1회차와 2회차에서 이미 틀렸는데 그냥 통과했던 번역이었다. 원문은 “인증된 사용자가 기밀 이슈 제목을 읽을 수 있다”인데, AI는 “인증되지 않은 사용자가”라고 썼다. 나도 처음 결과를 보고 “괜찮네”라고 넘겼던 문장이다.
공격자가 로그인이 필요한지 아닌지는 위험도 판단의 핵심이다. 사람 눈으로는 놓쳤고, 검사 규칙이 잡았다.
4회차에서 생긴 문제는 그다음 수정에서 나왔다. AI가 인증 여부를 자꾸 뒤집으니, 코드가 원문에서 인증 여부를 먼저 읽어 프롬프트에 정답으로 넣어줬다. 처음엔 “공격자: 인증된 사용자”라고 줬더니 AI가 “공격자는 인증된 사용자를 이용해”로 써서, 공격자가 다른 사람을 이용한다는 엉뚱한 뜻이 됐다. “문장은 ‘인증된 사용자가’로 시작한다”로 바꾸니 해결됐다.
결과 비교
| 항목 | 처음 (v1) | 고친 뒤 (v1.1) |
|---|---|---|
| 심각도 | Critical을 “중간”으로 | 원문 그대로 (12건 모두 정확) |
| 없는 CVE | 9건 생성 | 0건 (CVE 목록을 코드가 만든다) |
| 인증 여부 | 검사 없음 | 원문과 대조 |
| 다운타임 정보 | 서로 모순 | 원문 인용 |
| 처리 시간 | 약 5~6분 (추정) | 약 2분~2분 30초 (실측) |
처리 시간도 줄었다. AI에 넣는 입력이 짧아졌기 때문이다.
그래도 완벽하지는 않다. 마지막 결과에서도 “승인 정책을 우회할 수 있다”를 “권한을 부여받을 수 있다”로 옮긴 문장이 하나 있었다. 이런 미묘한 차이는 규칙으로 다 잡을 수 없다. 규칙을 하나 더 넣으면 AI는 다른 곳에서 또 어색하게 쓴다. 그래서 여기서 다듬기를 멈췄다. 판단은 원문 표와 주의사항으로, 번역은 내용을 빠르게 파악하는 용도로 역할을 나눴다.
배운 것
1. “LLM을 쓴다”와 “전부 LLM이 한다”는 다르다. 요구사항은 “LLM으로 요약할 것”이었는데, 나는 이걸 “읽고 판단하는 일을 전부 LLM에게”로 받아들였다. 원문에 이미 적힌 숫자를 AI에게 다시 옮겨 적게 할 이유는 없었다.
2. 정보를 주지 않고 답을 요구하면, AI는 지어낸다. “모르겠다”고 답하는 작은 모델은 거의 없다. 입력에 없는 것을 출력하라고 시키지 말아야 한다.
3. 검사 규칙이 곧 품질의 하한이다. 검사를 하나 넣을 때마다 이전 결과에 숨어 있던 오류가 드러났다. 사람이 “괜찮다”고 본 결과도 틀려 있었다.
4. 평가 없이 운영에 올리지 말 것. 처음엔 문장 하나를 번역시켜 보고 “잘 되네”라고 판단했다. 문장 하나 번역과 취약점 25개짜리 공지 정리는 전혀 다른 문제다. 실제 공지 하나를 원문과 끝까지 대조했다면, 운영 전에 잡았을 것이다.
5. 틀린 요약은 요약이 없는 것보다 나쁘다. “참고용이니까 틀려도 괜찮다”고 생각했다. 하지만 틀린 요약은 틀려 보이지 않는다. 읽는 사람은 원문 대신 요약을 믿는다. 특히 기술 배경이 없는 독자일수록 그렇다.
남은 과제
지금 봇은 “이 공지에 어떤 취약점이 있다”까지는 정확하게 알려준다. 하지만 “우리 서버가 해당되는가, 몇 버전으로 올려야 하는가”는 아직 사람이 판단한다. 이번에도 결국 사람이 원문을 보고 “이 건은 즉시 패치, 저 건은 다음 정기 업그레이드 때”라고 결론을 냈다.
다음 목표는 이 결론을 코드가 내는 것이다. 원문의 “7.0 이상 18.11.13 미만” 같은 영향 범위를 코드로 해석하고, 우리 버전과 숫자로 비교하면 된다. AI가 반대로 해석했던 바로 그 문장을, 이번엔 코드가 정확히 읽게 하려는 것이다. 이것도 틀리면 안 되는 일이라 AI에게 맡기지 않는다.