[로컬 LLM 보안 공지봇 1편] 4GB 서버에 오픈소스 LLM을 올려 보안 공지 알림봇을 만들었다
시리즈: 4GB 서버에 로컬 LLM으로 보안 공지봇 만들기
- 만든 과정과 설계 이유 ← 지금 글
- 첫 실전에서 AI가 틀린 이야기와 고친 방법
들어가며: 할 수 있는 것부터 해 보자
AI로 뭔가 하라는데, 쓸 수 있는 건 없었다
요즘 회사마다 “AI로 뭔가 해 보라”는 말이 나온다. 우리 회사도 그랬다. 하지만 그 말과 함께 주어진 것은 없었다. 쓸 수 있는 GPU 서버도, 외부 AI 서비스 예산도 없었다.
나도 하고 싶은 마음은 컸다. AI가 하루가 다르게 발전하는데, DevOps 엔지니어로서 그걸 업무에 써 보고 싶었다. 그래서 개인적으로 로컬 AI 에이전트를 직접 띄워 보기도 했다. 결과는 좌절이었다. 내 컴퓨터에서 돌아가는 작은 모델로는 “알아서 판단하고 일하는 에이전트”를 만들 수 없었다. 도구를 잘못 고르고, 같은 행동을 반복하고, 엉뚱한 답을 냈다. 쓸 만한 에이전트를 돌리려면 결국 큰 모델과 좋은 하드웨어가 필요했다. 둘 다 내게는 없었다.
그래서 질문을 바꿨다
“성능 좋은 AI 에이전트를 어떻게 만들까”를 내려놓고, 질문을 바꿨다.
지금 우리 팀에서, 내가 가진 조건으로 할 수 있는 일은 뭘까?
가진 것은 남는 서버 한 대(2코어, 메모리 4GB)와 오픈소스뿐이었다. 이 조건이면 똑똑한 에이전트는 무리다. 하지만 범위가 좁고 반복되는 일 하나라면 작은 모델로도 될 것 같았다.
마침 눈앞에 있던 일
마침 그 무렵 GitLab 보안 권고가 유난히 잦았다. 사내 GitLab과 Jenkins를 운영하는 입장에서, 공지가 올라올 때마다 읽고, 우리에게 급한지 판단하고, 업그레이드 일정을 잡아야 했다. GitLab은 매달 둘째·넷째 수요일에 정기 패치를 내고, 심각한 취약점이 나오면 그 사이에도 긴급 패치를 낸다.
이 일에는 불편한 점이 세 가지 있었다.
- 놓친다. 공지 페이지를 사람이 주기적으로 들어가 봐야 한다. 바쁘면 잊는다.
- 길고 영어다. 패치 공지 하나에 취약점이 10~25개, 버그 수정 목록이 수십 줄이다. 무엇이 급한지 파악하는 데만 한참 걸린다.
- 기록이 안 남는다. 공지를 봤더라도 업무 티켓으로 남기지 않으면, 언제 무엇을 확인하고 조치했는지 나중에 설명할 수 없다.
그래서 이런 생각이 들었다. “업데이트 소식을 LLM으로 요약해서 Jira에 자동으로 올리면 어떨까?”
이 일은 작은 모델에 잘 맞았다. 판단할 범위가 좁고(공지 하나를 읽고 정리하기), 입력 형식이 일정하고(공식 공지 페이지), 결과를 사람이 다시 확인한다(Jira 이슈). 목표는 두 가지였다. 팀에 조금이라도 보탬이 되는 것, 그리고 나 스스로 DevOps 일을 더 편하게 하는 것.
그렇게 감지 → 정리 → 기록을 자동으로 하는 작은 봇을 만들었다.
무엇을 만들었나
한 문장으로 하면 이렇다.
GitLab·Jenkins가 보안 공지를 올리면 30분 안에 알아채고, 서버 안에서 돌아가는 AI가 한국어로 정리해서, Jira에 업무 티켓(이슈)으로 올린다.
실제로 Jira에 올라온 이슈 화면이다. 회사 정보는 가렸다.
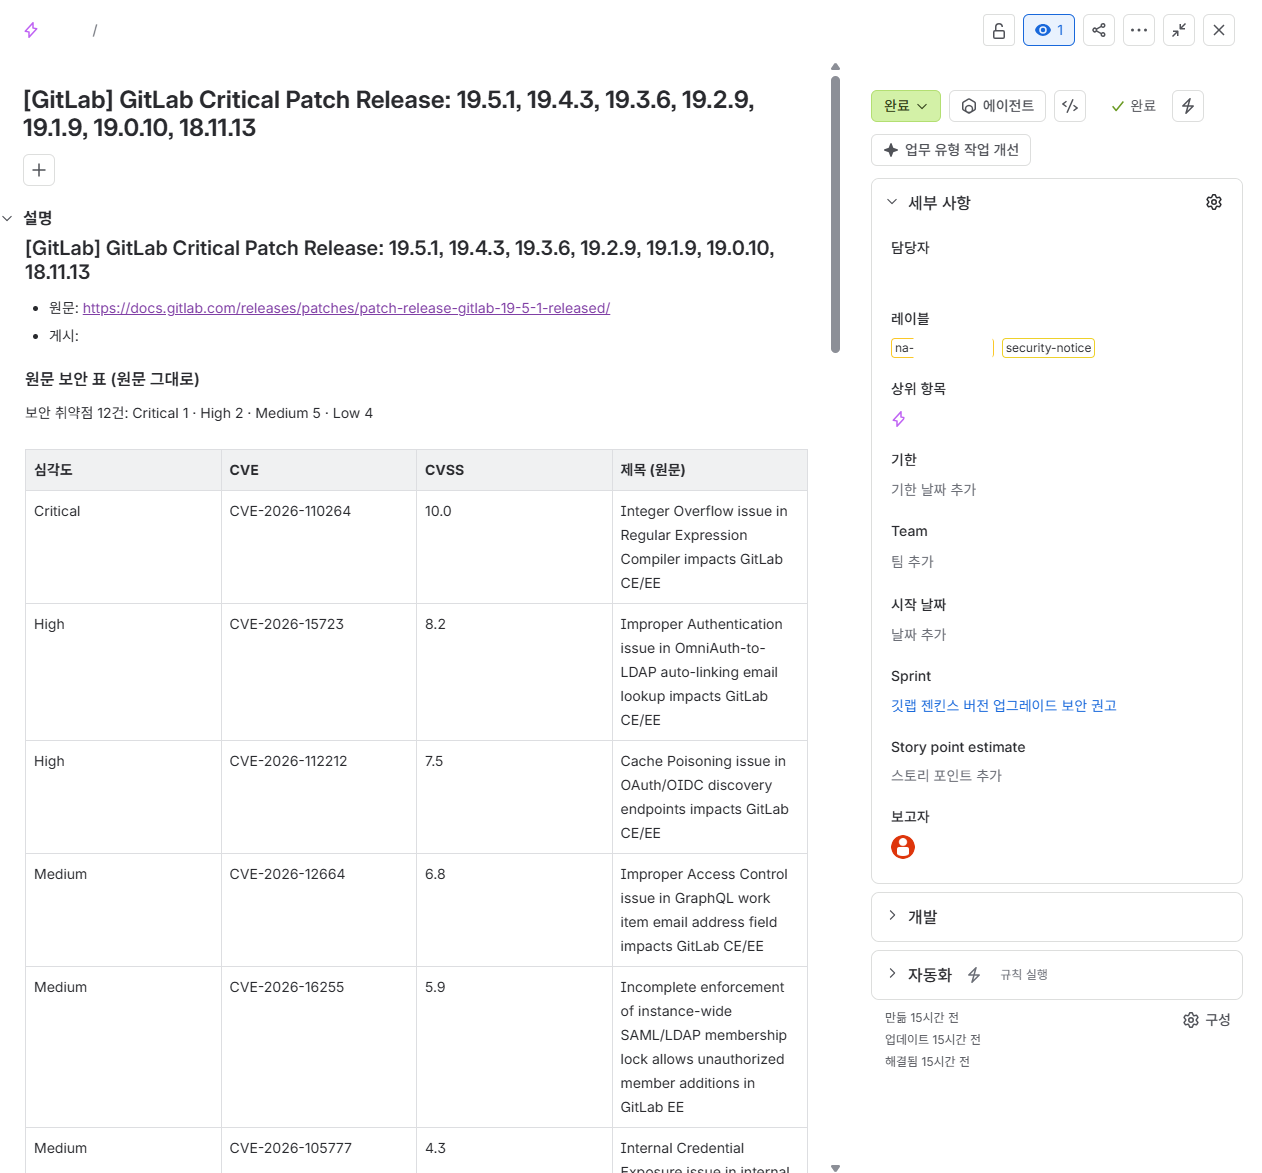 봇이 만든 Jira 이슈. 맨 위에 원문의 보안 표가 그대로 들어가고, 지정한 스프린트에 자동으로 등록된다
화면 아래쪽까지 포함한 본문 구성은 이렇다.
1
2
3
4
5
6
7
8
9
10
11
12
13
[GitLab] GitLab Critical Patch Release: 19.5.1, 19.4.3, ...

■ 원문 보안 표 (원문 그대로)
  보안 취약점 12건: Critical 1 · High 2 · Medium 5 · Low 4
  | 심각도   | CVE             | CVSS | 제목 (원문)                         |
  | Critical | CVE-2026-110264 | 10.0 | Integer Overflow issue in ...       |
  ...

■ AI 요약 (틀릴 수 있음. 판단은 위 표와 원문으로)
  개요: 19.5.1 등이 출시됐다. 즉시 업그레이드를 권장한다. ...
  업그레이드 주의사항 (원문 그대로): Single-node instances: ... downtime ...
  - CVE-2026-110264 (Critical): 비인증 사용자가 조작된 정규식으로 임의 코드를 실행할 수 있었다.
  ...
용어 몇 개만 짚고 가자.
| 용어 | 뜻 |
|---|---|
| CVE | 공개된 보안 취약점마다 붙는 고유 번호다. CVE-2026-110264처럼 생겼다 |
| CVSS | 취약점의 위험도를 0~10점으로 매긴 점수다. 10점이 가장 위험하다 |
| 심각도 | CVSS를 바탕으로 한 등급이다. Critical > High > Medium > Low 순이다 |
| LLM | ChatGPT 같은 대규모 언어 모델이다. 여기서는 영어 공지를 한국어로 옮기는 역할만 한다 |
주어진 조건
설계의 거의 모든 결정이 이 조건에서 나왔다.
| 조건 | 내용 |
|---|---|
| 서버 | 2코어 CPU, 메모리 4GB, 스왑 없음. 남는 서버 한 대를 썼다 |
| 이미 돌고 있는 것 | 보안·백업·로그 에이전트가 이미 메모리 1.5GB를 쓰고 있었다. 남은 건 약 2.3GB |
| 소프트웨어 | 오픈소스만 쓴다. AI 모델도 마찬가지다 |
| 외부 AI 서비스 | 쓰지 않는다. 서버 안에서 직접 돌린다 |
4GB 서버에서 AI를 돌린다고 하면 다들 “그게 돼?”라고 묻는다. 결론부터 말하면, 할 일을 잘 고르면 된다.
전체 구조
부품은 다섯 개다. 회사에 비유하면 이렇다.
| 부품 | 비유 | 하는 일 |
|---|---|---|
| systemd 타이머 | 알람 시계 | 30분마다 봇을 깨운다 |
| agent.py | 담당자 | 새 공지가 있는지 보고, 있으면 AI에게 정리를 맡기고, 결과를 저장한다 |
| state.db | 업무 일지 | 어떤 공지를 이미 처리했는지 적어 둔다. 같은 공지를 두 번 처리하지 않기 위해서다 |
| llama.cpp + Kanana 모델 | 번역 담당 | 영어 설명을 한국어로 옮긴다. 필요할 때만 출근한다 |
| jira-notify.py | 보고 담당 | 결과를 Jira 이슈로 올리고, 에픽·스프린트에 연결한다 |
핵심 결정과 그 이유
1. 새 공지 감지는 AI가 아니라 RSS로 한다
처음엔 “AI가 공지 페이지를 계속 지켜보면 되지 않나” 싶었다. 하지만 2코어 서버에서 AI는 가장 비싼 자원이다. 새 공지는 한 달에 몇 번 오는데, 그걸 확인하려고 AI를 매번 돌릴 이유가 없다.
GitLab과 Jenkins는 둘 다 RSS 피드를 제공한다. RSS는 사이트가 “새 글 목록”을 기계가 읽기 쉬운 형식으로 내놓는 것이다. 30분마다 이 목록을 받아서 처음 보는 공지가 있는지만 확인한다. 이 과정은 1초면 끝나고, 메모리도 거의 쓰지 않는다.
AI는 새 공지가 실제로 있을 때만 깨운다. 실제로 대부분의 실행은 “새 공지 없음”으로 1초 만에 끝난다.
2. 30분마다 깨우는 건 systemd 타이머에 맡긴다
리눅스에는 원래 cron이라는 예약 실행 도구가 있다. 그래도 systemd 타이머를 골랐다.
| 비교 | cron | systemd 타이머 |
|---|---|---|
| 실행 로그 | 직접 파일로 남겨야 함 | 자동으로 남는다 (journalctl) |
| 서버가 꺼져 있던 동안 놓친 실행 | 버린다 | 켜지면 한 번 보충한다 |
| 이전 실행이 안 끝났을 때 | 또 실행된다 | 겹쳐 실행하지 않는다 |
마지막 줄이 중요했다. 공지가 몰려서 처리가 길어졌는데 다음 실행이 겹치면, AI가 두 개 뜨면서 메모리가 터질 수 있다.
동작 원리는 단순하다. 리눅스가 부팅하면 가장 먼저 뜨는 systemd라는 프로그램이 있고, 이게 항상 떠 있다. 타이머 설정에 “매시 0분, 30분”이라고 적어 두면, systemd가 그 시각에 커널 알람을 걸어 두고 잔다. 시각이 되면 깨어나서 agent.py를 한 번 실행한다. agent.py 안에는 반복문이 없다. 한 번 돌고 끝난다. 반복은 systemd가 책임진다. 그래서 agent.py가 한 번 오류로 죽어도 30분 뒤에는 다시 정상으로 돈다.
3. 모델은 카카오의 Kanana 1.5 2.1B
조건은 세 가지였다. 오픈소스 라이선스일 것, 4GB 서버에 들어갈 것, 한국어를 잘할 것.
| 후보 | 결과 | 이유 |
|---|---|---|
| Kakao Kanana 1.5 2.1B | 채택 | Apache 2.0 라이선스, 한국어 특화, 크기 적당 |
| Qwen 계열 | 예비 후보 | 라이선스는 좋지만 한국어 문장이 가끔 어색하다 |
| OLMo, SmolLM | 제외 | 학습 데이터까지 공개한 ‘완전 오픈소스’지만 한국어가 약하다 |
| Llama, Gemma | 제외 | 자체 라이선스라 엄밀한 의미의 오픈소스가 아니다 |
| EXAONE | 제외 | 한국어는 좋지만 비상업 라이선스라 회사 업무에 못 쓴다 |
같은 Kanana라도 버전마다 라이선스가 다르다. Apache 2.0인 것은 kanana-1.5-2.1b-instruct-2505다.
2.1B는 모델 안의 숫자(파라미터)가 약 21억 개라는 뜻이다. 원래 크기로는 4GB가 넘는다. 그래서 양자화를 했다. 숫자 하나를 16비트에서 약 4비트로 줄여 저장하는 것이다. 사진을 압축하는 것과 비슷하다. 화질이 조금 떨어지지만 크기가 크게 줄어든다. 결과 파일은 1.5GB였다.
모델 파일은 남이 변환해 올린 것을 받지 않고, 카카오 공식 원본을 받아 직접 변환했다. 10분 정도 더 걸리지만, 보안 감사에서 “이 파일은 어디서 왔냐”고 물으면 “공식 원본에서 우리가 직접 만들었다”고 답할 수 있다.
4. AI는 Docker로, 필요할 때만 띄운다
AI를 실행하는 프로그램으로는 llama.cpp를 썼다. CPU만 있는 서버에서 가볍게 돌아가도록 만들어진 오픈소스(MIT)다. 공식 Docker 이미지가 있어서 서버에 따로 설치할 것도 없었다.
1
2
3
4
5
6
docker run -d --rm --name notice-llm \
  -p 127.0.0.1:8080:8080 \
  --memory=2400m --cpus=1.5 \
  -v /opt/llm/models:/models:ro \
  ghcr.io/ggml-org/llama.cpp:server \
  -m /models/kanana-1.5-2.1b-instruct-Q4_K_M.gguf -c 2048 -t 2 -np 1
옵션 몇 개의 이유만 짚는다.
| 옵션 | 이유 |
|---|---|
--rm | 끝나면 컨테이너를 지운다. 새 공지가 있을 때만 띄우고 끝나면 내리므로, 평소 메모리 사용은 0이다 |
-p 127.0.0.1:... | 서버 안에서만 접근하게 한다. llama.cpp 서버에는 로그인 기능이 없어서, 밖에 열면 누구나 쓸 수 있다 |
--memory=2400m | 메모리 상한이다. 넘치면 이 컨테이너만 종료된다. 기존 보안·백업 에이전트가 휘말리지 않게 하기 위해서다 |
--cpus=1.5 | 2코어 중 0.5코어는 다른 프로그램 몫으로 남긴다 |
-c 2048 | AI가 한 번에 읽을 수 있는 분량(컨텍스트)을 줄였다. 크게 잡을수록 메모리를 더 쓴다 |
실제로 재 보니 이랬다.
| 항목 | 실측 |
|---|---|
| 모델 로딩 | 약 21초 |
| 한국어 생성 속도 | 초당 약 18.5토큰 |
| 메모리 사용 | 1.44GB |
| 공지 1건 처리 | 약 2분~2분 30초 (취약점 12건 기준) |
4GB 서버에서도 충분히 돌아갔다.
5. Jira 연동: 중복을 막고, 보드에 보이게
Jira 이슈를 만드는 건 Jira REST API를 호출하면 된다. 실제로 신경 쓴 건 두 가지다.
같은 공지로 이슈가 두 번 생기지 않게 했다. Jira 응답이 늦어 “실패”로 기록되면, 30분 뒤에 다시 시도한다. 그런데 사실 첫 시도에서 이슈가 이미 만들어졌을 수도 있다. 그래서 공지 URL로 고유한 라벨(na-1c3454e35e4c 같은)을 만들어 붙이고, 이슈를 만들기 전에 같은 라벨이 있는지 먼저 검색한다.
보드에 보이게 했다. Jira 보드는 진행 중인 스프린트에 들어 있는 이슈만 보여준다. 이슈만 만들면 백로그에 묻힌다. 그래서 지정한 에픽에 연결하고, 지정한 이름의 스프린트를 찾아 넣도록 했다.
구축 순서
실제로 진행한 순서다. 가장 불확실한 것(4GB에서 AI가 정말 도는가)을 가장 먼저 확인했다.
- 서버 상태 확인.
free -h로 남은 메모리를,ps aux --sort=-rss로 누가 메모리를 쓰는지를 봤다.curl로 공지 사이트와 모델 저장소에 나갈 수 있는지도 확인했다. - 모델 준비. 공식 가중치를 받아 GGUF 형식으로 변환하고 4비트로 양자화했다. 중간 파일(약 8GB)은 지웠다.
- AI 단독 테스트. 컨테이너를 띄우고 문장 하나를 번역시켜 속도와 메모리를 쟀다.
- 봇 설치. 코드를
/opt에, 설정을/etc에 두고 타이머를 켰다. - Jira 연동. 설정 점검 명령으로 인증·프로젝트·에픽·보드를 하나씩 확인한 뒤 실제 이슈를 만들어 봤다.
설치할 때 한 가지 장치를 넣었다. 설치 직후 첫 실행에서는 피드에 있는 과거 공지 수십 건이 전부 “새 공지”로 보인다. 그대로 두면 Jira 이슈 수십 개가 한꺼번에 생긴다. 그래서 설치할 때 현재 공지를 모두 “이미 본 것”으로 기록해 두고, 그 이후에 올라온 공지만 처리하게 했다.
겪은 함정 두 가지
1. 서버의 명령어 기록 장치. 이 서버에는 sudo로 실행한 명령을 기록하는 감사 장치가 있었다. 그런데 이 장치가 rm -rf의 -rf 같은 옵션을 자기 옵션으로 잘못 읽어서 오류를 냈다. 명령 자체는 실행되는데 기록만 실패하는 상황이었다. 그래서 봇의 수동 실행 명령을 대시(-) 없는 단어로 만들었다. sudo bash run.sh jira-check처럼 쓰면 옵션은 스크립트 안에만 있어서 감사 장치와 부딪히지 않는다. 감사 기록을 건너뛰는 우회 방법도 있었지만 쓰지 않았다. 감사 장치는 이유가 있어서 있는 것이기 때문이다.
2. Jira의 “simple” 보드. 스프린트를 찾으려고 보드 유형이 scrum인지 확인하게 했는데, 우리 보드는 simple로 나왔다. Jira Cloud의 팀 관리형 프로젝트 보드는 API에서 simple로 표시된다. 스프린트 기능을 켜면 스크럼처럼 쓸 수 있어서 simple도 허용하도록 고쳤다. 문서만 보고 짠 코드는 실제 응답 앞에서 한 번씩 틀린다.
한계와 남은 과제
잘 돌아가는 부분만 쓰면 반쪽짜리 글이다. 지금 이 봇이 못 하는 것도 분명히 적어 둔다.
지금의 한계
| 한계 | 구체적으로 | 왜 이렇게 됐나 |
|---|---|---|
| “우리가 해당되나?”는 판단하지 못한다 | 어떤 취약점이 있는지는 알려주지만, 우리 버전이 영향 범위에 드는지, 몇 버전으로 올려야 하는지는 사람이 원문을 보고 판단한다 | 처음 버전은 이 판단을 AI에게 맡겼다가 영향 범위를 거꾸로 읽었다. 틀리면 안 되는 판단이라 일단 뺐다 |
| AI 번역이 가끔 틀린다 | 큰 줄기는 맞지만, “권한 검사를 우회“를 “권한을 부여“처럼 뜻을 비틀어 옮기기도 한다 | 2.1B 모델의 한계다. 그래서 이슈에 “AI 요약은 틀릴 수 있다”는 경고를 붙이고, 숫자와 등급은 AI를 거치지 않게 했다 |
| Jenkins 공지는 표를 뽑지 못한다 | GitLab 공지는 보안 표를 그대로 붙이지만, Jenkins 공지는 “표를 찾지 못했다”로 나온다 | 두 사이트의 공지 형식이 다르다. 먼저 공지가 잦은 GitLab에 맞췄다 |
| 공지 형식이 바뀌면 깨진다 | 보안 표는 공지 페이지 HTML에서 “Severity” 열이 있는 표를 찾아 읽는다 | 공식 API가 없어서 웹 페이지 구조에 기댈 수밖에 없다. 바뀌면 “표를 찾지 못했다”로 드러나도록만 해 뒀다 |
| 실패해도 조용하다 | 같은 공지를 3번 연속 처리하지 못하면 더 시도하지 않는다. 그 사실을 사람에게 알리지 않는다 | 처음엔 성공 경로만 만들었다. 지금은 서버 로그(journalctl)를 봐야 안다 |
| 품질을 자동으로 재지 못한다 | 프롬프트나 모델을 바꿨을 때 더 나아졌는지는 사람이 결과를 읽어 보고 판단한다 | 정답 데이터를 만들어 두지 않았다. 이번 수정도 실제 공지 한 건으로 다섯 번 재시험한 것이 전부다 |
남은 과제
우선순위 순서다. 기준은 “틀렸을 때 피해가 큰 것부터” 다.
- 해당 여부를 코드로 판단하기. 원문의 “7.0 이상 18.11.13 미만” 같은 영향 범위를 코드로 해석해 우리 버전과 숫자로 비교한다. 이게 되면 이슈 맨 위에 “우리 버전 해당: 3건, 19.x.y로 업그레이드 필요”처럼 결론이 바로 나온다. 실제로 사람이 가장 알고 싶은 것이 이것이다. 숫자 비교라서 AI 없이 정확하게 할 수 있다.
- 실패하면 알리기. 3번 실패한 공지는 “자동 처리 실패, 원문 확인 필요”라는 이슈로라도 올린다. 보안 공지를 놓치지 않는 것이 이 봇의 첫 번째 목적이기 때문이다. 요약은 실패해도 되지만, 알림까지 실패하면 안 된다.
- 정답셋으로 평가하기. 지난 공지 몇 건에 대해 “올바른 결과”를 만들어 두고, 코드나 모델을 바꿀 때마다 자동으로 비교한다. 이번 실패를 늦게 발견한 이유가 평가 없이 바로 운영에 넣었기 때문이다.
- Jenkins 공지 형식 지원. Jenkins 공지 구조에 맞는 추출기를 따로 만든다.
- 더 나은 모델로 바꿔 끼우기. 모델 파일과 프롬프트만 바꾸면 되도록 만들어 뒀다. 같은 크기에서 한국어를 더 잘하는 오픈소스 모델이 나오면, 3번 정답셋으로 비교해 보고 나을 때만 바꾼다.
이 중 1번과 2번이 되면, 이 봇은 “공지를 정리해 주는 도구”에서 “조치가 필요한지 알려주는 도구” 가 된다.
마치며
GPU도 예산도 없었지만, 할 수 있는 범위를 좁히니 만들 수 있는 것이 생겼다. 대단한 에이전트는 아니다. 그래도 이제 보안 공지를 놓치지 않고, 아침에 Jira를 열면 정리된 이슈가 기다리고 있다. 팀에도, 나에게도 작지만 실제로 쓰이는 도구가 됐다.
4GB 서버에서도 AI를 쓸 수 있었다. 비결은 하나였다. AI가 할 필요 없는 일은 AI에게 시키지 않는 것. 감지는 RSS로, 반복은 systemd로, 기록은 SQLite로 하고, AI는 새 공지가 있을 때만 잠깐 불렀다.
그런데 이 원칙을 요약 단계에서는 지키지 못했다. 처음 버전은 공지 정리를 통째로 AI에게 맡겼고, 첫 실전 공지에서 Critical 취약점을 “중간”이라고 보고했다. 그 이야기와 고친 방법은 2편에 정리했다.
사용한 것들
| 구성 요소 | 라이선스 |
|---|---|
| Kakao Kanana 1.5 2.1B Instruct | Apache 2.0 |
| llama.cpp | MIT |
| Python 3 표준 라이브러리, SQLite, systemd, Docker | 각 오픈소스 라이선스 |
Python 외부 패키지는 하나도 쓰지 않았다. 보안 에이전트가 깔린 감사 대상 서버에 패키지를 늘리면, 그만큼 출처와 취약점을 관리할 대상도 늘어나기 때문이다.